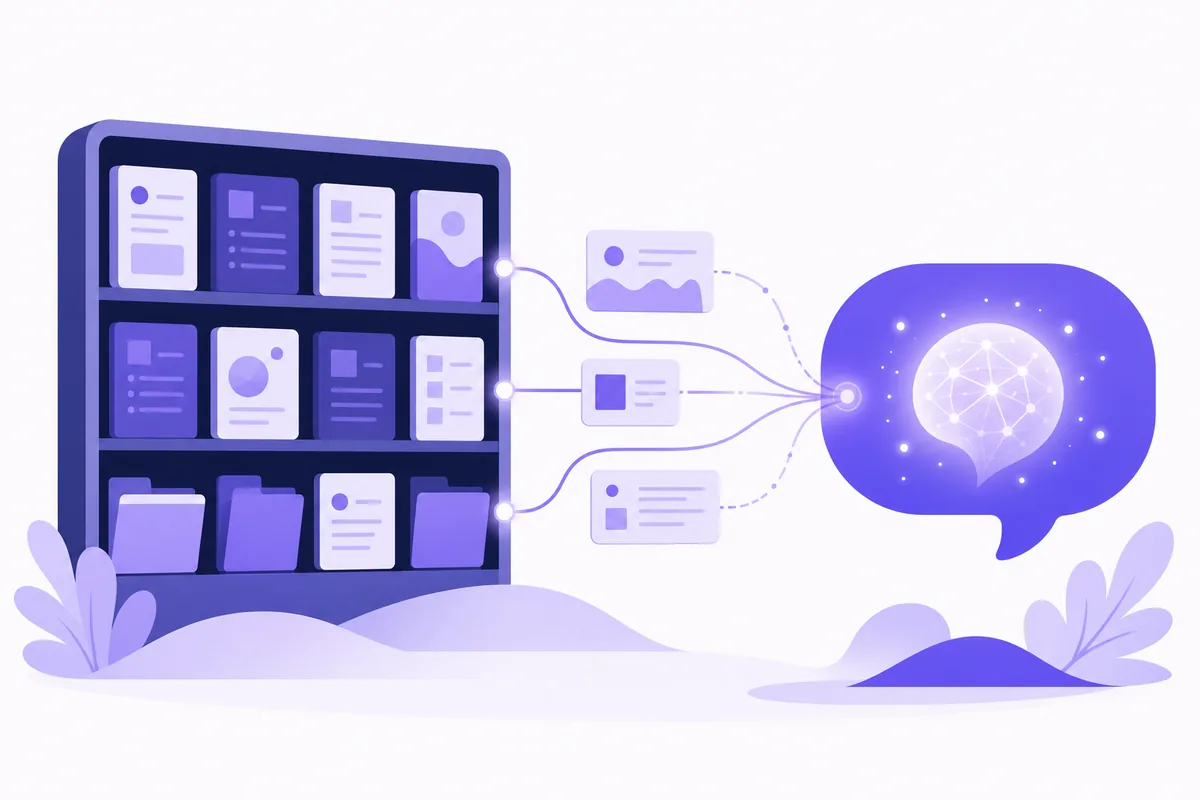
Kunskapsbas och RAG är sättet att låta en AI svara utifrån dina egna dokument: kunskapsbasen innehåller materialet, RAG hämtar relevanta delar och modellen formulerar svaret. Därför dyker begreppet ofta upp när du läser om AI-agenter utan programmering och vill förstå hur de kan använda aktuell information i stället för bara sin grundträning.
I korthet
- RAG betyder att AI först hämtar relevant information och sedan skriver sitt svar.
- En kunskapsbas är en sökbar samling dokument, rutiner, webbsidor eller andra källor.
- Att ladda upp en fil i en chatt räcker ofta för engångsfrågor, men en sparad kunskapsbas passar bättre för återkommande användning.
- RAG är en metod, inte en egen AI-modell och inte samma sak som att träna om modellen.
- De vanligaste riskerna är gamla dokument, motstridiga källor, känsliga uppgifter och otydliga instruktioner.
Vad betyder RAG (enkelt förklarat)?
RAG står för Retrieval-Augmented Generation. På svenska kan det förklaras som hämtning förstärkt med generering: systemet letar först upp relevant underlag och använder sedan underlaget när svaret skrivs.
När används den svenska benämningen?
I praktiken används oftast förkortningen RAG även på svenska. Den fulla svenska beskrivningen dyker främst upp i utbildningstexter, interna förklaringar och när man vill göra begreppet begripligt för nybörjare. I vardagligt språk räcker det ofta att säga att AI:n hämtar ur dina dokument innan den svarar.
Är RAG samma sak som en AI-modell?
Nej. RAG är en metod eller uppbyggnad runt modellen, inte modellen i sig. Om du vill förstå skillnaden mellan hur modellen fungerar i grunden och hur den får extra sammanhang, läs gärna Hur AI fungerar.
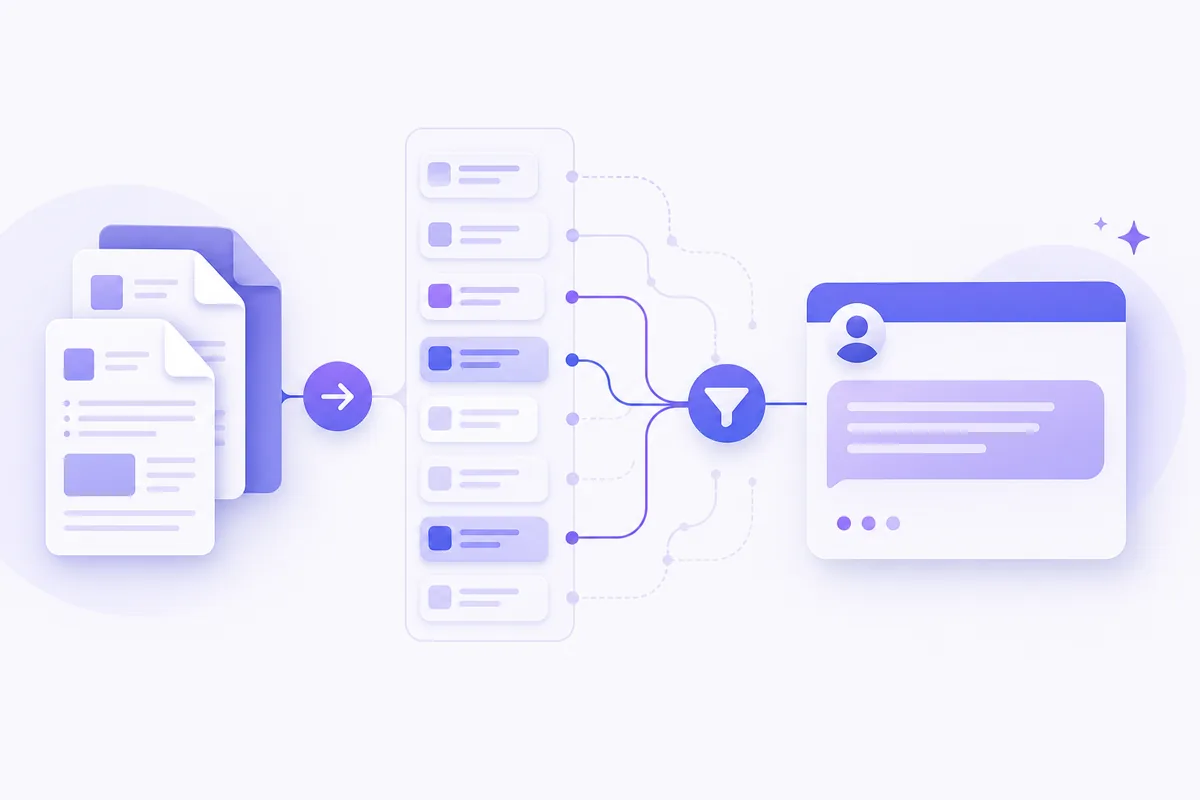
En kunskapsbas innehåller informationen. RAG hittar rätt delar. AI-modellen använder de delarna för att formulera svaret.
Vad är en kunskapsbas för AI?
En kunskapsbas är en samling information som AI kan söka i när någon ställer en fråga. Det kan vara företagets rutiner, produktblad, prislistor, avtal, manualer eller vanliga kundfrågor.
Poängen är inte att göra AI:n “smartare” i allmänhet, utan att ge den rätt underlag för just ditt ämne. Det är särskilt användbart när svaren ska bygga på sådant som inte finns i modellens vanliga träning eller som ändras över tid.
Vilka filer kan ingå?
Det vanligaste är textbaserade dokument och sidor som går att söka i. Ju tydligare och mer välordnat materialet är, desto bättre brukar svaren bli.
- PDF-filer med markerbar text
- Word-dokument och andra textdokument
- Kalkylblad med priser, villkor eller listor
- Presentationsfiler med tydligt textinnehåll
- Webbsidor, interna guider och FAQ-material
Skannade eller bildbaserade PDF:er fungerar ofta sämre, eftersom texten inte alltid går att läsa ut ordentligt. Om du börjar enkelt med filuppladdning i chatt är det bäst att använda rena, tydliga och aktuella dokument.
Är en kunskapsbas samma sak som att träna om AI?
Nej. När du använder en kunskapsbas får modellen tillgång till materialet vid frågetillfället. Det är något annat än att träna om modellen, vilket är ett större och helt annat arbete. Hur träningen går till förklaras i hur AI tränas.
För de flesta nybörjare och små verksamheter är en kunskapsbas mycket enklare att underhålla. Du kan byta ut ett dokument, lägga till en ny rutin eller ta bort gammalt material utan att behöva ändra hela AI-systemet.
Kort sagt: en fil i en chatt är som att lägga ett papper på skrivbordet just nu. En kunskapsbas är som ett organiserat arkiv som AI kan slå i om och om igen. RAG är själva sökningen som hittar rätt sida i arkivet.
Hur fungerar RAG i praktiken?
RAG kan beskrivas utan teknisk jargong. Det viktiga är att AI:n inte börjar med att gissa fritt, utan att systemet först försöker hitta relevanta delar från dina källor.
Fyra enkla steg
Frågan kommer in
Någon frågar till exempel vad returvillkoren säger eller vilket pris som gäller.
Systemet letar efter rätt textdelar
Det söker inte i allt på samma sätt varje gång, utan försöker hitta de avsnitt som bäst matchar frågan.
Relevanta utdrag skickas med
De hittade avsnitten följer med som sammanhang när modellen ska formulera sitt svar.
Svaret skrivs
Modellen skriver sedan ett svar utifrån både frågan och det hämtade underlaget.
I många system delas dokument upp i mindre textbitar, till exempel korta stycken eller avsnitt. När någon frågar “Hur lång returrätt har kunden?” jämför systemet frågan med dessa bitar och väljer kanske utdraget där det står “Retur inom 14 dagar” i stället för att skicka med hela policydokumentet.
Sökningen kan bygga på ord, betydelse eller båda samtidigt. Det gör att systemet ibland kan hitta ett relevant avsnitt även om frågan och dokumentet inte använder exakt samma ord, så länge de handlar om samma sak.
Vad är embeddings?
För att kunna söka på betydelse och inte bara på exakta ord gör många RAG-system om varje textbit till en embedding, en lång lista med tal som beskriver vad texten handlar om. Texter med liknande innebörd får liknande tal. När en fråga kommer in görs den också om till en embedding, och systemet hämtar de textbitar som ligger närmast. Därför kan frågan ”Hur länge får man ångra ett köp?” hitta stycket om ”returrätt i 14 dagar”, trots att orden skiljer sig. Embeddings sparas ofta i en så kallad vektordatabas.
Varför behöver inte AI läsa alla filer varje gång?
När dokumenten redan är uppdelade och sökbara behöver systemet bara skicka vidare några relevanta utdrag. Det sparar tid och gör svaret mer fokuserat, särskilt när materialet är stort.
Det betyder inte att hämtningen alltid blir perfekt. Om dokumenten är osorterade, dubbla eller motsäger varandra kan systemet ändå ta med fel underlag.
Är RAG samma sak som att ladda upp en PDF?
Nej, men upplevelsen kan likna varandra. När du laddar upp en fil i en chatt får AI:n tillgång till just den filen i den aktuella situationen, medan en kunskapsbas är tänkt att återanvändas över tid.
När räcker filuppladdning?
Filuppladdning räcker ofta när du vill lösa en enskild uppgift snabbt. Ett inloggat gratiskonto räcker ofta för manuella tester, men gratisanvändare har en låg daglig gräns för filuppladdningar och den kan sänkas vid hög belastning.
- Du vill sammanfatta ett avtal eller en rapport.
- Du vill hitta ett visst avsnitt i en manual.
- Du vill jämföra ett fåtal dokument i ett enstaka samtal.
- Du vill testa idén innan du bygger något mer permanent.
För filuppladdning är det bra att känna till att en fil kan vara upp till 512 MB och att skannade PDF:er ofta läses sämre än textbaserade dokument. Om du vill ha den praktiska genomgången för just detta, läs Ladda upp PDF i ChatGPT, som äger hela steg-för-steg-guiden.
Snabbt beslut: räcker filen eller behövs något sparat?
Ett enkelt beslutskriterium är detta: om samma material ska användas igen efter den här chatten, eller av fler än en person, är det ofta dags för en sparad arbetsyta, assistent eller kunskapsbas i stället för en tillfällig filuppladdning.
| Behov | Enklast lösning |
|---|---|
| Enstaka fråga om ett dokument | Ladda upp filen i en chatt |
| Samma filer i flera samtal | Sparad arbetsyta eller assistent |
| Många frågor från flera användare | Kunskapsbas med RAG |
| Uppdaterad information från andra system | Koppling via ett API, alltså en förbindelse som låter tjänster utbyta data |
När behövs en kunskapsbas?
Du behöver inte börja med en stor lösning. Många har mer nytta av att först testa med några välordnade dokument och sedan bygga vidare när behovet blir tydligt.
Vilka signaler visar att du har vuxit ur filuppladdning?
- Du laddar upp samma filer om och om igen.
- Flera personer behöver svar från samma underlag.
- Materialet ändras ofta och gamla versioner ställer till det.
- Du vill kunna hänvisa till källor eller dokument på ett mer konsekvent sätt.
- Du vill att en AI-agent ska använda materialet återkommande utan manuell uppladdning varje gång.
Vad är enklast för en nybörjare?
Börja med ett litet och tydligt ämne, till exempel returpolicy, prislista eller en intern rutin. Om AI:n redan där hittar rätt och svarar konsekvent har du ett bra tecken på att materialet lämpar sig för en större kunskapsbas senare.
Testa själv: välj en offentlig eller ofarlig PDF, ladda upp den i en chatt och be AI:n svara endast utifrån dokumentet. Kontrollera sedan minst ett svar mot originalet. Fungerar det bra vet du att principen håller innan du bygger något större.
Hur lägger man till kunskap i en AI-agent?
Det finns flera vägar, och vilken som är bäst beror mest på hur ofta materialet ska användas. På den här sidan räcker det att förstå alternativen, inte att bygga hela lösningen.
Tre vanliga sätt
- Ladda upp filer direkt: bäst för tillfälliga frågor och små test.
- Använd en sparad assistent eller arbetsyta: bra när samma material och samma instruktioner ska återanvändas.
- Koppla en sökbar datakälla: bäst när agenten ska hämta rätt information automatiskt från många källor eller från system som ändras.
Dokumenten räcker sällan ensamma. En agent behöver också tydliga riktlinjer för ton, språk, källhänvisning och vad den ska göra när information saknas. För den delen äger sidan om instruktioner till en AI-agent den djupare genomgången.
Vilket sätt är enklast att börja med?
Det enklaste är nästan alltid att börja manuellt: en chatt, några få dokument och tydliga frågor. Först när du ser att samma behov kommer tillbaka är det rimligt att gå vidare till en mer permanent lösning, till exempel en assistent, ett arbetsflöde eller en riktig RAG-baserad agent.
Finjustering, RAG eller bara bättre prompt?
Det finns flera sätt att få en AI att svara utifrån din verksamhet. Börja alltid med det enklaste som fungerar.
| Metod | Vad den gör | Passar när | Nackdel |
|---|---|---|---|
| Bättre prompt | Du skriver sammanhang, regler och exempel direkt i instruktionen. | Uppgiften är liten och underlaget får plats i chatten. | Måste upprepas och räcker inte för stora dokumentmängder. |
| RAG med kunskapsbas | Systemet söker fram rätt textbitar ur dina dokument vid varje fråga. | Svaren ska bygga på många eller ofta uppdaterade dokument. | Kräver att dokumenten hålls aktuella och väl strukturerade. |
| Finjustering | Modellen tränas vidare på dina egna exempel så att den ändrar beteende eller stil. | Du vill ha ett fast format, en viss ton eller en specialiserad uppgift i stor skala. | Dyrare och mer tekniskt, och lär inte modellen aktuella fakta på ett pålitligt sätt. |
| MCP-koppling | AI:n hämtar data eller utför åtgärder live i andra system via en standardiserad koppling. | Svaret behöver aktuell information från till exempel ett CRM, en kalender eller ett ärendesystem. | AI:n får åtkomst till riktiga system, så behörigheter måste begränsas noga. |
RAG eller MCP? RAG söker i dokument som du har sparat i förväg, medan MCP (Model Context Protocol) är en öppen standard som Anthropic lanserade 2024 för att låta AI-verktyg ansluta till andra tjänster och hämta data i stunden. De kan kombineras: en assistent kan använda RAG för policyer och rutiner, och MCP för att slå upp en enskild kunds order.
För de flesta nybörjare och småföretag är ordningen: förbättra prompten först, lägg sedan till en kunskapsbas, och överväg finjustering först när de andra sätten inte räcker.
Vilka risker och begränsningar finns?
RAG minskar inte alla problem. Metoden gör det lättare att ge AI rätt underlag, men kvaliteten beror fortfarande på dokumenten, instruktionerna och din kontroll av svaren.
Inaktuella dokument
Om kunskapsbasen innehåller en gammal prislista eller en ersatt rutin kan AI:n hämta just den. RAG gör alltså inte informationen aktuell av sig självt; någon måste fortfarande byta ut gammalt material.
Motstridiga källor
När två dokument säger olika saker kan svaret bli osäkert eller fel. Därför är versionsdatum, tydliga filnamn och en uttalad huvudkälla ofta viktigare än själva tekniken.
Känsliga uppgifter
Personuppgifter, kunddata, avtal och intern affärsinformation kräver extra försiktighet. Innan du laddar upp något bör du kontrollera tjänstens villkor, behörigheter och om materialet verkligen behöver delas med en extern AI-tjänst. För ett bredare säkerhetsperspektiv, se AI-säkerhet och källkritik.
Otydliga instruktioner
En kunskapsbas bestämmer inte automatiskt hur svaret ska presenteras. Om du vill att AI:n ska svara kort, ange källa, använda svenska eller säga ifrån när något saknas måste du skriva det tydligt i instruktionerna.
Vanliga frågor
Behöver jag kunna programmera för att använda RAG?
Nej, inte för att förstå principen eller testa den i liten skala. Filuppladdning, sparade assistenter och enklare verktyg kan ge en RAG-liknande upplevelse utan kod, medan mer avancerade lösningar kan kräva mer teknisk konfiguration.
Lär sig AI:n mina dokument permanent?
Inte automatiskt på det sätt många tror. Filer kan användas som sammanhang i en chatt, ett projekt eller en tjänst, men exakt lagring och behandling beror på tjänstens villkor och inställningar. Om du är osäker, utgå inte från att allt är privat eller permanent skyddat.
Måste dokumenten vara perfekt strukturerade från start?
Nej. Du kan börja med material som är ”tillräckligt bra” och förbättra stegvis. En enkel städning gör ofta stor skillnad: ta bort dubbletter, namnge filer tydligt, markera aktuell version och dela upp långa dokument i tydliga avsnitt.
Hur många dokument behövs innan det räknas som en kunskapsbas?
Det finns ingen magisk gräns. En enda manual kan räcka om målet är att ställa bra frågor om just den, medan andra behov kräver många källor. Det viktiga är inte mängden utan att materialet är relevant, aktuellt och går att söka i.
Källor
- https://help.openai.com/en/articles/8555545-file-uploads-faq
- https://help.openai.com/en/articles/8983675-what-types-of-files-are-supported
- https://help.openai.com/en/articles/10169521-projects-in-chatgpt
- https://platform.openai.com/docs/guides/embeddings
- https://modelcontextprotocol.io/
- https://www.anthropic.com/news/model-context-protocol
Vad är nästa steg?
Vill du gå vidare praktiskt, börja med att testa dokument i liten skala och bygg först därefter. En bra ordning är att först prova ladda upp PDF i ChatGPT, sedan läsa om AI-assistenter och därefter fördjupa dig i instruktioner till en AI-agent.
Om du vill förstå hur dokument kan kopplas till större arbetsflöden kan du fortsätta till API utan kod och tillbaka till navet för AI-agenter utan programmering. När du sedan testar egna svar är det klokt att också läsa så faktagranskar du AI-svar steg för steg.
Den här guiden är skriven och faktakontrollerad av AI-agenter mot källorna ovan, som en del av maskinlarning.se – en sajt som byggs helt av AI.
Senast uppdaterad: 26 oktober 2026