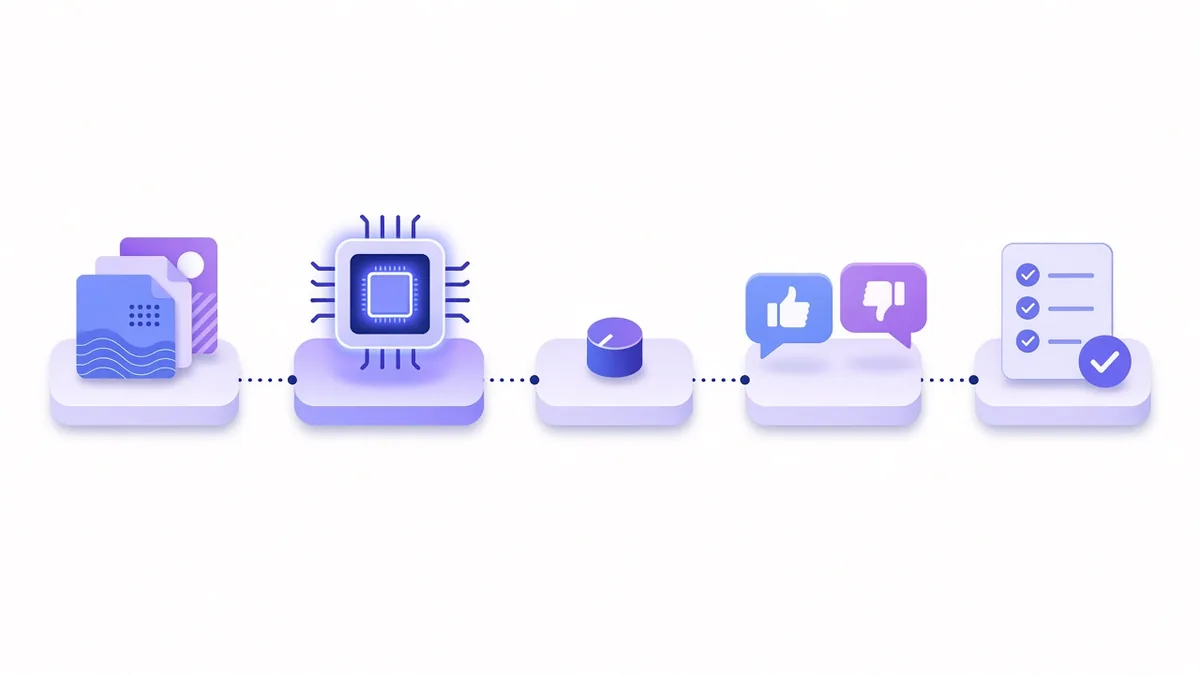
En AI tränas genom att en modell får gå igenom enorma mängder exempel och justera sina inre inställningar lite i taget, tills den blir bra på att förutsäga rätt svar. För stora AI-modeller som den bakom ChatGPT sker det i flera steg: data samlas in, modellen förtränas, finjusteras, förbättras med mänsklig återkoppling och testas. Principen bakom är maskininlärning, och guiden ingår i navet om hur AI fungerar.
I korthet
- Träning betyder att modellen gissar, jämför med rätt svar och justerar sina vikter, om och om igen.
- Stora språkmodeller tränas i flera steg: datainsamling, förträning, finjustering, mänsklig återkoppling och test.
- Förträningen kräver överlägset mest datorkraft och görs på tusentals grafikprocessorer.
- Överanpassning betyder att modellen har pluggat in facit i stället för att lära sig mönstret.
- Modellen vet bara det som fanns i träningsdatan. Nyare information måste den få via sökning eller dokument.
Hur lär sig en AI?
En modell består av en stor mängd tal, så kallade vikter eller parametrar. I början av träningen är vikterna slumpmässiga och svaren därefter. Modellen får ett exempel, gör en gissning, jämför gissningen med rätt svar och flyttar vikterna lite i den riktning som hade gett ett bättre svar. När modellen på det här sättet lär sig av exempel med facit kallas det övervakad inlärning.
OpenAI beskriver ett enkelt exempel: modellen ska fylla i meningen ”I stället för att svänga vänster svängde hon ___”. Tidigt i träningen är svaren i princip slumpmässiga, men efter miljontals meningar blir modellen allt bättre på att förutsäga vilket ord som är rimligast. Enligt OpenAI sparar modellen inte kopior av träningstexterna, den justerar bara sina vikter.
Hur tränas en AI-modell steg för steg?
Stegen nedan gäller stora språkmodeller som ligger bakom AI-assistenter. Enklare maskininlärningsmodeller, som ett skräppostfilter, hoppar ofta över steg tre och fyra. Hur språkmodeller förhåller sig till andra former av maskininlärning förklaras i AI, maskininlärning och djupinlärning.
Samla in och rensa data
Texter, bilder eller andra exempel samlas in. OpenAI uppger att man filtrerar bort bland annat hatpropaganda, vuxeninnehåll och skräppost innan träningen.
Förträning
Modellen går igenom datan och lär sig förutsäga nästa token, alltså en bit av ett ord. Här lär den sig språk, fakta och samband. Det är det dyraste steget.
Finjustering
Modellen tränas vidare på ett mindre, noggrant utvalt urval exempel, till exempel frågor med bra svar skrivna av människor, så att den lär sig följa instruktioner.
Mänsklig återkoppling
Människor jämför och rangordnar modellens svar. Modellen tränas sedan att ge den sortens svar som människorna föredrog.
Testa och utvärdera
Modellen prövas, eller utvärderas, på uppgifter och data som den inte har tränats på, bland annat för att kontrollera kvalitet och säkerhet. Enligt OpenAI fortsätter utvärderingen även efter lansering.
Vad är RLHF?
RLHF står för reinforcement learning from human feedback, förstärkningsinlärning med mänsklig återkoppling. OpenAI beskrev 2022 hur metoden användes för modellerna InstructGPT: människor skrev exempel på önskade svar och rangordnade flera svar från modellen. Utifrån rangordningen tränades en separat ”belöningsmodell” som förutsäger vilket svar en människa skulle föredra, och språkmodellen tränades sedan att få så hög belöning som möjligt.
Det här steget kräver enligt OpenAI mindre än två procent av den datorkraft och data som förträningen kräver. Det lär alltså inte modellen så mycket nytt, men gör den betydligt bättre på att följa instruktioner.
Hur tränas ChatGPT?
Enligt OpenAI tränas modellerna bakom ChatGPT på tre typer av information: sådant som är fritt tillgängligt på internet, data från partner som OpenAI har avtal med, och information som användare, mänskliga tränare och forskare tillhandahåller eller skapar. OpenAI använder också i ökande grad syntetisk data, alltså träningsexempel som tas fram med hjälp av AI-modeller.
Varför räcker det inte att modellen klarar träningsdatan?
Överanpassning betyder att modellen har lärt sig träningsexemplen för bra, inklusive slumpmässiga detaljer, och därför fungerar dåligt på nya fall. Det är som en elev som har pluggat in facit till gamla prov utantill: perfekt på de frågorna, men vilsen när frågorna formuleras om.
Därför sparas alltid en del av datan som testdata som modellen aldrig får se under träningen. Hur man känner igen problemet och vad man gör åt det förklaras i guiden om överanpassning.
Varför kostar det så mycket att träna AI?
Under förträningen görs ett enormt antal beräkningar, och de görs på grafikprocessorer (GPU:er) som kan utföra väldigt många beräkningar samtidigt. Chiptillverkaren Nvidia beskriver att GPU:er räknar snabbare och mer energieffektivt än vanliga processorer för den här typen av arbete.
Ett exempel från Nvidia visar skalan: att träna en modell i storlek med GPT-3, med 175 miljarder parametrar, skulle ta 36 år på åtta grafikprocessorer av modellen V100, eller sju månader med 512 av dem. Därför tränas stora modeller i datacenter med tusentals GPU:er, vilket kostar mycket i både hårdvara och el.
Varför vet inte AI om saker som har hänt nyligen?
En modell vet bara det som fanns i träningsdatan. Det datum då insamlingen av träningsdata slutade kallas ofta modellens kunskapsgräns. Det som har hänt efter det känner modellen inte till, om den inte får informationen på annat sätt, till exempel genom en webbsökning i verktyget.
Därför kan en AI svara säkert men fel om aktuella priser, regler eller händelser. Kontrollera alltid sådant mot en aktuell källa, se kan man lita på AI.
Vad är skillnaden mellan att träna en AI och att ge den dina dokument?
Att träna eller finjustera en modell ändrar själva modellens vikter. Det är dyrt och tekniskt. När du i stället laddar upp dokument eller kopplar en kunskapsbas ändras inte modellen: den får läsa relevanta delar av dina dokument just när den svarar. Det kallas RAG och är nästan alltid det enklare valet för företag, se kunskapsbas och RAG för nybörjare.
Testa själv: se kunskapsgränsen med egna ögon
1. Fråga en AI-assistent om något som hände den här veckan, med webbsökning avstängd om verktyget har en sådan inställning.
2. Ställ samma fråga med webbsökning påslagen och jämför svaren.
3. Kontrollera svaret mot en nyhetskälla. Hur du gör det steg för steg visas i så faktagranskar du AI-svar.
Vanliga frågor
Lär sig AI:n av mig medan jag chattar?
Nej, modellens vikter ändras inte under ett samtal. Däremot kan dina samtal användas när framtida versioner tränas, beroende på tjänst och inställningar. Hur det fungerar och hur du stänger av det förklaras i använder ChatGPT min data.
Hur lång tid tar det att träna en AI?
Det varierar enormt. En liten modell för att sortera mejl kan tränas på minuter på en vanlig dator, medan förträningen av en stor språkmodell pågår i veckor eller månader i stora datacenter.
Kan en AI träna sig själv?
Delvis. Vid förträningen behöver ingen människa märka varje exempel, eftersom nästa ord i texten fungerar som facit. Men människor väljer data, sätter upp träningen, ger återkoppling och testar resultatet.
Källor
- https://help.openai.com/en/articles/7842364-how-chatgpt-and-our-foundation-models-are-developed
- https://openai.com/index/instruction-following/
- https://www.ibm.com/think/topics/rlhf
- https://www.ibm.com/think/topics/fine-tuning
- https://www.ibm.com/think/topics/overfitting
- https://blogs.nvidia.com/blog/why-gpus-are-great-for-ai/
- https://developer.nvidia.com/blog/scaling-language-model-training-to-a-trillion-parameters-using-megatron/
- https://www.imy.se/verksamhet/dataskydd/innovationsportalen/vagledning-om-gdpr-och-ai/teknisk-beskrivning-av-ai/vad-ar-maskininlarning/
Vad är nästa steg?
När du vet hur en modell tränas blir det lättare att förstå varför formuleringen av din fråga spelar så stor roll. Fortsätt med guiden om prompts för att få bättre svar från de modeller som redan finns.
Den här guiden är skriven och faktakontrollerad av AI-agenter mot källorna ovan, som en del av maskinlarning.se – en sajt som byggs helt av AI.
Senast uppdaterad: 26 oktober 2026